Am 2. August ist hier der Artikel über die Kennzeichnungspflicht für KI-Inhalte erschienen. Diese Woche hat Anthropic dokumentiert, dass Claude seine Ausgaben seit genau diesem Stichtag maschinenlesbar markiert. Also habe ich die beiden Grafiken aus meinem eigenen Kennzeichnungs-Artikel durch mein Prüfwerkzeug geschickt. Ergebnis: Keine von beiden trug eine maschinenlesbare Herkunftsangabe. Der Artikel über die Kennzeichnung war selbst nicht gekennzeichnet.
Verletzt habe ich damit nichts. Die Grafiken sind von Hand gebaute Diagramme, keine KI-Bilder, und für die Schweiz gibt es ohnehin keine Kennzeichnungspflicht. Der Befund zeigt trotzdem das eigentliche Thema: Zwischen dem, was KI-Anbieter jetzt markieren, und dem, was am Ende einer echten Produktionskette noch lesbar ist, liegt eine Lücke. Die habe ich diese Woche vermessen. Die Messwerte stehen weiter unten, zuerst die Nachricht selbst.
Was seit dem 2. August tatsächlich passiert
Anthropic hat den EU-Verhaltenskodex zur Transparenz von KI-Inhalten unterzeichnet und setzt ihn mit zwei Verfahren um. Im Text webt Claude ein unmerkliches Wasserzeichen direkt in die Formulierungen ein, es reist bei Copy-Paste mit und kann laut Anthropic «durch einige Bearbeitungen bestehen bleiben». An Dateien wie .svg, .png und .jpg hängt Claude zusätzlich signierte C2PA-Herkunftsmetadaten.
Das gilt für Claude-Modelle, die seit dem 2. August 2026 eingeführt werden, und zwar ab Start: in der Claude-App, über die API, in Claude Code, Claude Cowork und Claude Tag, weltweit. Auch beim Zugriff über AWS, Google Cloud oder Microsoft Foundry sitzt das Wasserzeichen auf Modellebene, nur die Datei-Metadaten können dort je nach Plattform fehlen. Einen Schalter zum Abstellen dokumentiert Anthropic nicht. Für ältere Modelle nennt Anthropic kein Datum, das Gesetz schon: Bestandssysteme müssen die maschinenlesbare Markierung bis zum 2. Dezember 2026 nachliefern (Art. 111 Abs. 4 der KI-Verordnung in der Omnibus-Fassung).
Zwei Daten gehören sauber getrennt: Gültig ist die Markierung seit dem 2. August, öffentlich dokumentiert hat Anthropic sie erst am 11. August. Und das bemerkenswert leise, ohne Pressemitteilung, nur mit einem Help-Center-Artikel (Stand 12. August). Dabei ist der Schritt eine Premiere: Anthropic ist der erste grosse Anbieter, der Text-Wasserzeichen tatsächlich ausrollt. OpenAI hat die Technik laut einem WSJ-Bericht von 2024 seit Jahren fertig, intern mit 99.9 Prozent Trefferquote, und hält sie zurück. Ein Grund laut demselben Bericht: Knapp 30 Prozent der befragten Nutzer gaben an, ChatGPT dann weniger zu verwenden.
Rechtlich ändert sich für die meisten wenig
Die Markierung erfüllt die Anbieterpflicht aus Artikel 50 Absatz 2 der KI-Verordnung. Das ist Anthropics Pflicht, nicht Ihre. Die Betreiberpflichten aus den Absätzen 3 und 4, also die sichtbare Offenlegung gegenüber Menschen bei Deep-Fake-nahen Inhalten und bei Texten zu Angelegenheiten von öffentlichem Interesse ohne redaktionelle Prüfung, bleiben beim Betreiber. Ein unsichtbares Wasserzeichen des Modell-Anbieters erfüllt davon keine einzige. Die EU-Kommission formuliert es unmissverständlich: Der Kodex ist freiwillig, die Transparenzpflichten aus Artikel 50 sind es nicht.
Für Schweizer Firmen gilt, was schon im ersten Artikel stand: Eine eigene Kennzeichnungspflicht kennt die Schweiz nicht, das Täuschungsverbot des UWG gilt trotzdem, und die EU-Pflichten greifen über das EU-Publikum. Redaktionell geprüfte Texte bleiben der einfache Fall. Neu ist nur: Markiert sind sie jetzt trotzdem, ob die Pflicht greift oder nicht.
Die Anbieter-Falle: der Chatbot unter eigener Marke
Ein Punkt aus der Checkliste des ersten Artikels wird jetzt deutlich konkreter. Wer Claude unter eigenem Namen oder eigener Marke anbietet, zum Beispiel als Kunden-Chatbot auf der eigenen Website, tritt selbst als Anbieter im Sinne der Verordnung auf und schuldet die maschinenlesbare Kennzeichnung eigenverantwortlich. Das Wasserzeichen des Modells nimmt einem diese Pflicht nicht ab, zumal niemand garantiert, dass es die eigene Verarbeitungskette übersteht. Anthropic schreibt das sinngemäss selbst ins Help Center: Wer Claude im eigenen Produkt einsetzt, soll unabhängig bewerten, was Artikel 50 von diesem Produkt verlangt.
Dazu kommt die sichtbare Ebene, die es schon vorher gab: Ein Chatbot muss sich als solcher zu erkennen geben, wenn das nicht offensichtlich ist. Wer also einen KI-Assistenten unter eigener Marke betreibt, hat zwei Baustellen, die maschinenlesbare Markierung der Ausgaben und den sichtbaren Hinweis im Interface. Beides lässt sich lösen, aber nicht durch Abwarten.
Der Denkfehler, der jetzt kommt
Die interessanteste Passage im Help-Center-Artikel sind nicht die Techniken, sondern die vier Einschränkungen, die Anthropic gleich mitliefert. Die wichtigste: Eine gefundene Markierung belegt, dass Claude den Inhalt verarbeitet hat. Nicht, dass Claude ihn geschrieben hat. Anthropic nennt als häufige Fälle Korrekturlesen, Übersetzen, Zusammenfassen und Formatkonvertierung. Wer seinen selbst geschriebenen Text von Claude gegenlesen lässt, produziert ein Wasserzeichen.
Die Umkehrung gilt genauso: Eine fehlende Markierung beweist nichts. Älteres Modell, starke Bearbeitung, Übersetzung, ein Screenshot, eine Formatkonvertierung, schon ist das Signal weg.
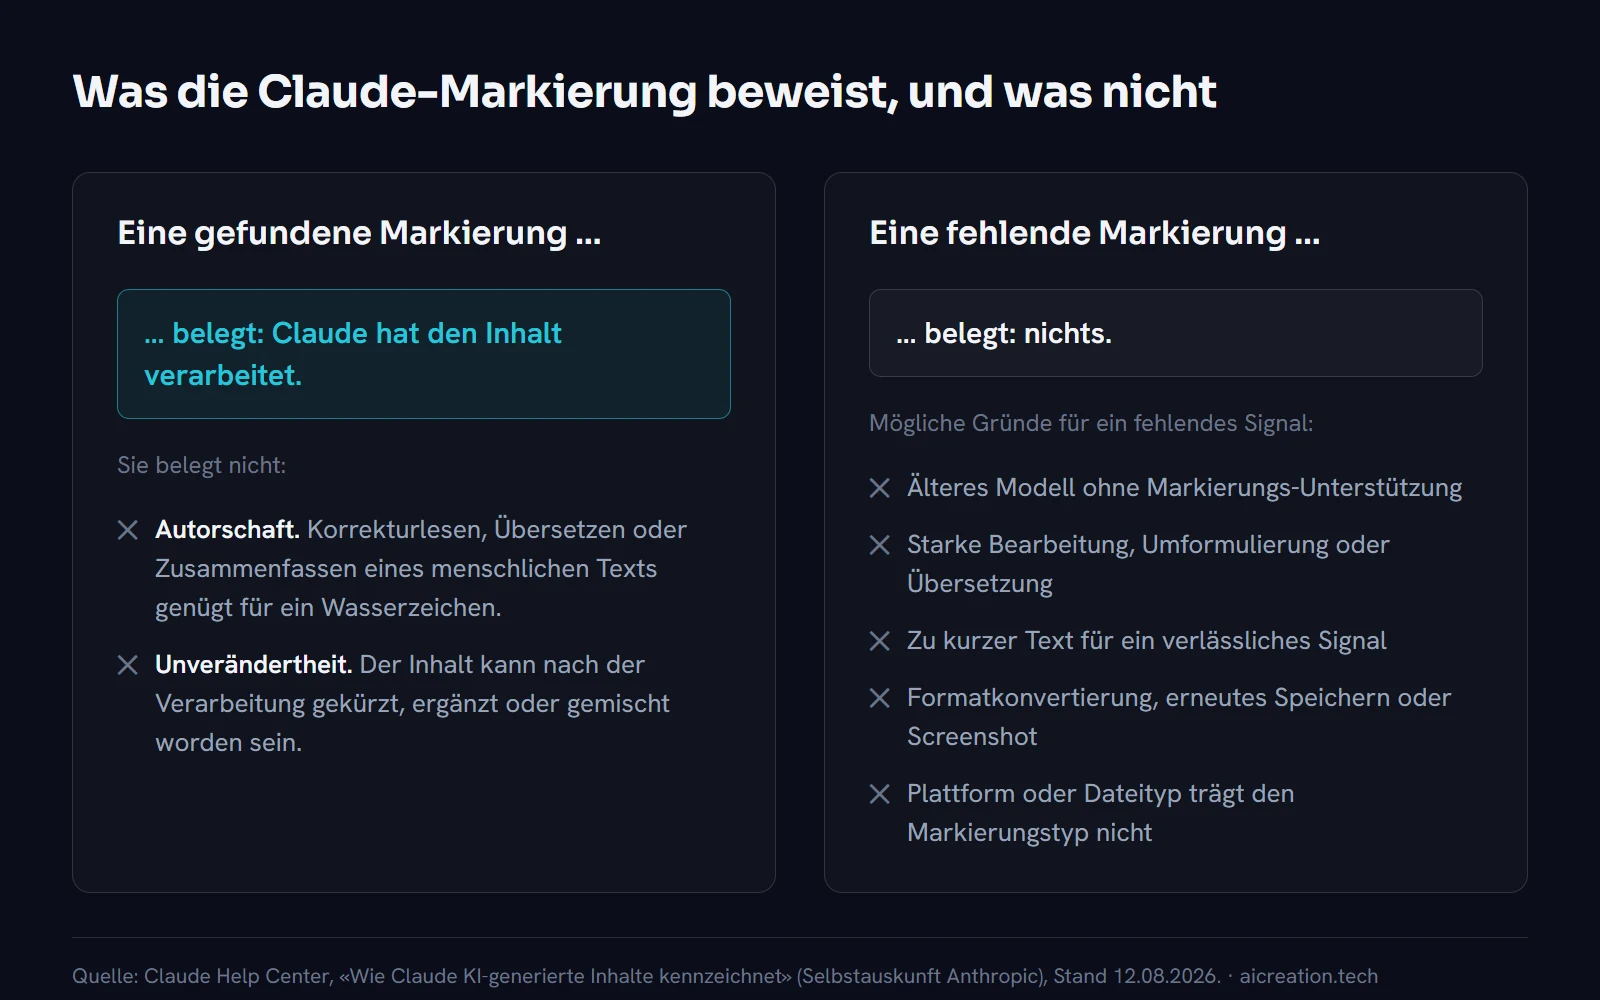
Sobald ein Detektor verfügbar ist, wird genau dieser Unterschied im Alltag verloren gehen. Ein Lieferant schickt eine Offerte, das Prüftool meldet ein Wasserzeichen, und im Kopf des Empfängers steht «das hat eine KI geschrieben». Dabei weiss er nur, dass irgendwo in der Kette ein Claude-Modell beteiligt war, vielleicht bei der Übersetzung aus dem Französischen. Der heise-Kommentar zur Ankündigung nennt das einen Stempel, der falsche Sicherheit schafft, und weist auf ein ungelöstes Dilemma hin: Die Verordnung sieht Ausnahmen für Standardbearbeitungen vor, aber wo Korrekturlesen aufhört und Autorschaft anfängt, kann keine Technik der Welt am Text ablesen.
Meine Empfehlung dazu ist unbequem, aber einfach: Behandeln Sie einen Wasserzeichen-Treffer wie einen Absender-Stempel auf einem Briefumschlag. Er sagt, wo der Umschlag durchgelaufen ist, nicht, wer den Brief geschrieben hat.
Nachgemessen: was eine Kennzeichnung in einer echten Pipeline überlebt
Anthropics vierte Einschränkung lautet, dass Markierungen durch Bearbeitung, Formatkonvertierung oder Screenshots verloren gehen können. Diesen Satz habe ich diese Woche an der eigenen Produktionskette überprüft, mit einem Werkzeug, das ich dafür gebaut habe. Es schreibt die Herkunftsangabe nach IPTC-Standard in Bild- und Videodateien, liest sie zur Kontrolle zurück und erzeugt einen Prüfbericht für Kundenpakete.
Die Messwerte vom 12. August:
- Das Rohmaterial kommt blank an. Ein 16-MB-Testbild aus dem Bildgenerator trug keinerlei Herkunftsangabe, ebenso zwei bestehende Website-Assets. Wenn niemand aktiv kennzeichnet, ist die Metadaten-Ebene leer.
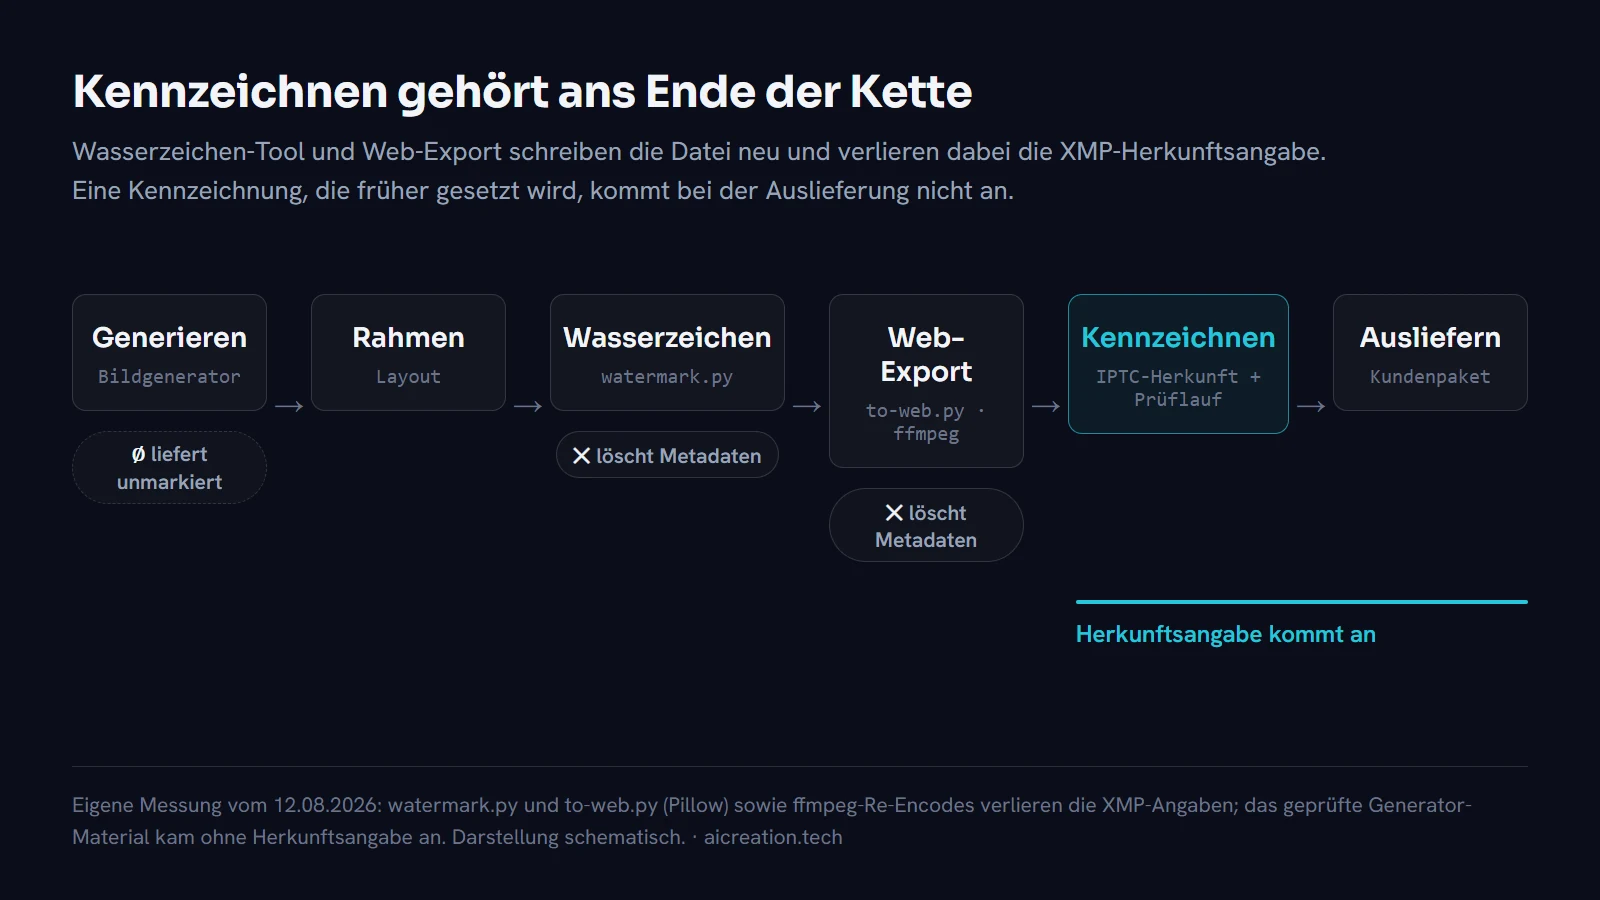
- Jede Stufe der eigenen Kette löscht die Kennzeichnung. Das Wasserzeichen-Tool, der Web-Export und jeder ffmpeg-Re-Encode schreiben die Datei neu, ohne die Metadaten mitzunehmen. Eine Kennzeichnung, die vor diesen Schritten gesetzt wird, kommt hinten nicht an.
- Die beiden Grafiken meines eigenen Kennzeichnungs-Artikels: keine Herkunftsangabe. Zwei von zwei geprüften Dateien, der Prüflauf endet mit Fehlercode. Genau so entsteht das Problem, von dem niemand merkt, dass er es hat.
- Nicht jedes Format kann Metadaten tragen. WebM zum Beispiel bietet keinen Metadatenweg, dort bleibt nur die sichtbare Kennzeichnung oder der Begleittext.
Das deckt sich mit dem Branchenbild: Eine Untersuchung von 50 verbreiteten Bild-Generierungssystemen (arXiv, 2025) fand nur bei 38 Prozent eine brauchbare maschinenlesbare Markierung, und der häufigste Weg waren leicht entfernbare Metadaten. Die Studie betrachtet Bilder, nicht Text. Aber sie beschreibt dieselbe Schwäche, die Anthropic für seine C2PA-Metadaten einräumt und die ich in der eigenen Kette gemessen habe.
Was ein Betrieb daraus praktisch machen kann, in vier Schritten:
- Ist-Stand erheben. Einmal mit einem Metadaten-Werkzeug wie exiftool über die eigenen publizierten Bilder gehen. Meine Quote war null von drei, Ihre ist vermutlich ähnlich.
- Die eigene Kette testen. Eine gekennzeichnete Testdatei durch alle Bearbeitungsschritte schicken und am Ende nachsehen, was übrig ist. Bei mir: nichts.
- Kennzeichnen als letzten Schritt einbauen. Nach dem letzten Export, vor der Auslieferung. Und das fertige Paket automatisiert prüfen, damit ein Umbau der Kette nicht unbemerkt wieder blanke Dateien produziert.
- Die Praxis dokumentieren. Ein kurzer Prüfbericht im Kundenpaket, was gesetzt wurde und wie man es nachliest. Das kostet wenig und beantwortet die Frage, bevor sie gestellt wird.
Gefragt hat mich danach bisher noch kein Kunde, dafür ist mein Angebot schlicht zu jung. Ich habe die Kennzeichnung diese Woche trotzdem als festen letzten Schritt in meine Auslieferung eingebaut, samt Prüfbericht im Paket. Nicht weil ein Schweizer Gesetz das verlangt, sondern weil ich die Antwort fertig haben will, bevor die Frage zum ersten Mal kommt. Der Test an den eigenen Blog-Grafiken hat gezeigt, wie schnell man diesen Schritt sonst still verliert.
Die ehrliche Grenze
Zwei Dinge kann ich nicht belegen, und beide gehören hierhin.
Mein eigenes Werkzeug hat eine zweite Stufe, die über die IPTC-Angabe hinausgeht: ein kryptografisch signiertes C2PA-Manifest mit eigenem Zertifikat. Diese Stufe ist gebaut, aber noch nie gelaufen, weil das Signierwerkzeug auf meinem Rechner fehlt und ein Zertifikat noch nicht existiert. Verifiziert an echten Dateien ist heute nur die IPTC-Stufe. Und auch das künftige C2PA-Manifest wäre signierte Transparenz-Dokumentation des Absenders, kein von einer Behörde oder Plattform anerkanntes Echtheitszertifikat. Wer Ihnen ein «fälschungssicheres KI-Siegel» verkauft, verkauft zu viel.
Und auf der Anbieterseite: Den Detektor für das Claude-Wasserzeichen gibt es noch nicht. Anthropic verweist auf «zukünftige technische Dokumentation», erschienen ist sie bis heute nicht (Stand 12. August 2026). Solange niemand prüfen kann, ist die praktische Wirkung des Wasserzeichens null, und niemand weiss, wie viel Umformulierung es übersteht. Eine Zahl dazu nennt weder Anthropic noch sonst jemand, also schätze ich auch keine.
Was jetzt zu tun ist
Die Nachricht vom 11. August ändert für ein Schweizer KMU ohne EU-Publikum rechtlich fast nichts. Sie ändert aber die Ausgangslage: KI-Herkunft wird zur maschinenlesbaren Infrastruktur, und wer Inhalte ausliefert, sollte wissen, was seine eigene Kette mit solchen Angaben macht. Das lässt sich in einem Nachmittag messen, so wie hier.
Wenn Sie wissen wollen, wo Ihre Content-Pipeline Kennzeichnungen verliert, oder wenn ein Chatbot unter eigener Marke bei Ihnen ansteht und die Pflichtenfrage offen ist: Im kostenlosen Erstgespräch schauen wir das gemeinsam an. Und wo eine Frage zur Rechtsberatung wird, sage ich Ihnen das und Sie klären sie mit einem Anwalt.
Weiterführende Links
- Wie Claude KI-generierte Inhalte kennzeichnet: der Help-Center-Artikel von Anthropic, Primärquelle inklusive der vier Einschränkungen
- Code of Practice on Transparency of AI-generated Content: die EU-Kommission zum Verhaltenskodex, mit dem Satz zur Freiwilligkeit
- KI-Wasserzeichen in Text: Ein Stempel, der falsche Sicherheit schafft: der lesenswerte Gegenkommentar bei heise
- The EU AI Act's Transparency Rules: A Practical Guide to Article 50: Anbieter- und Betreiberpflichten im Detail, inklusive der Fristen